Google EmbeddingGemma 2 Diperkenalkan untuk Memahami Teks Gambar Audio dan Video
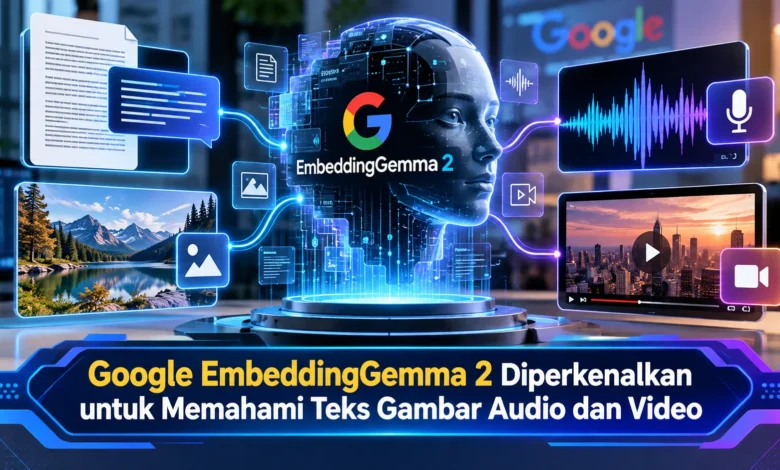
Google kembali menghadirkan inovasi teknologi kecerdasan buatan melalui peluncuran EmbeddingGemma 2 pada 6 Oktober 2026. Model AI terbaru ini dirancang untuk memahami hubungan makna antara teks, gambar, audio, dan video melalui sistem representasi data yang terintegrasi. Berbeda dari model yang hanya berfokus pada satu jenis informasi, EmbeddingGemma 2 memungkinkan pengembang membangun pencarian multimedia yang lebih fleksibel dan efisien. Dengan arsitektur ringan yang dapat dijalankan langsung pada perangkat pengguna, inovasi ini membuka peluang pengembangan aplikasi cerdas tanpa selalu bergantung pada komputasi berbasis cloud. Kehadirannya juga menunjukkan bagaimana teknologi AI semakin diarahkan menuju pemrosesan informasi yang praktis, hemat sumber daya, dan memperhatikan privasi.
Perkembangan Teknologi Multimodal melalui Kehadiran EmbeddingGemma 2
Kehadiran Google EmbeddingGemma 2 merupakan langkah penting dalam evolusi teknologi kecerdasan buatan yang dirancang memahami sejumlah format konten secara bersamaan. Model ini dikembangkan oleh Google DeepMind dengan sistem pemrosesan multimodal yang mendukung pengintegrasian hubungan makna dari teks, gambar, audio, dan video. Berkat sistem tersebut, para pembuat perangkat lunak dapat mengembangkan fitur pencarian yang semakin beragam terhadap berbagai skenario penggunaan. Untuk memberikan gambaran, seseorang bisa menemukan gambar berdasarkan deskripsi teks tanpa bergantung pada judul file secara langsung. Kemampuan ini membuka peluang bagi layanan digital masa depan untuk mengelola informasi dengan lebih efektif.
Salah satu karakteristik utama dari EmbeddingGemma 2 adalah kebutuhan komputasi yang dioptimalkan untuk perangkat penggunaan sehari-hari. Google mengembangkan model ini dengan sekitar 740 juta parameter yang dibangun menggunakan bagian pemrosesan terpisah. Dibandingkan pendekatan yang mengandalkan sistem AI berukuran sangat besar, EmbeddingGemma 2 dikembangkan untuk menjalankan tugas representasi informasi dengan beban komputasi yang lebih terukur. Desain semacam ini menghadirkan manfaat bagi pengembang layanan berbasis perangkat lokal yang berencana membangun fitur AI tanpa memerlukan pemrosesan jarak jauh. Namun demikian, kecepatan pemrosesan aktual tetap dipengaruhi oleh kemampuan perangkat keras dan jenis data yang diproses.
Cara Kerja Teknologi Multimodal pada EmbeddingGemma 2
Ketika mempelajari cara kerja EmbeddingGemma 2, prinsip dasar yang layak diperhatikan adalah embedding atau pemodelan makna melalui angka. Melalui proses ini, berbagai jenis konten diubah menjadi vektor pada ruang representasi bersama. EmbeddingGemma 2 mendukung representasi dengan ruang vektor 768 dimensi untuk menggambarkan hubungan makna dari konten yang diproses. Secara sederhana, deskripsi tertulis mengenai gambar dapat menunjukkan kemiripan vektor dengan foto yang relevan. Kesamaan tersebut membantu sistem pencarian mencocokkan konten berdasarkan makna meskipun format kontennya tidak sama. Meski demikian, embedding bukanlah hasil penjelasan lengkap seperti yang dihasilkan model percakapan.
Kemampuan pemrosesan lintas media ini turut memungkinkan pemrosesan masukan multimedia campuran dalam satu input terintegrasi. Sebagai ilustrasi, database barang digital dapat menyertakan keterangan produk, foto barang, dan video demonstrasi untuk membentuk representasi yang lebih kaya. Melalui pengolahan semacam itu, aplikasi dapat mempelajari kedekatan antara komponen multimedia tanpa menghilangkan karakteristik setiap media. Pembuat aplikasi setelah itu dapat memanfaatkan hasil embedding untuk pencarian semantik. Walaupun konsepnya mudah dijelaskan, kualitas hasil pencarian tetap membutuhkan pengujian berdasarkan dataset yang digunakan.
Kemampuan Model AI Google Menghemat Sumber Daya Perangkat
Keunggulan teknis lainnya dari EmbeddingGemma 2 adalah penerapan struktur model modular berdasarkan jenis pekerjaan. Ketika hanya memproses teks, model bisa menggunakan komponen dengan sekitar 270 juta parameter. Untuk kemampuan tambahan, pengembang dapat menyertakan encoder visual dengan kapasitas 170 juta parameter serta encoder audio dengan 300 juta parameter. Struktur modular tersebut memungkinkan penyesuaian dalam mengatur beban perangkat. Melalui strategi ini, aplikasi yang hanya membutuhkan pencarian teks tidak harus memuat seluruh encoder multimedia. Hal tersebut menjadi penting untuk laptop dengan memori terbatas.
Di samping pembagian komponen, EmbeddingGemma 2 dilengkapi dengan Matryoshka Representation Learning atau MRL yang memungkinkan mengurangi jumlah dimensi embedding. Dalam bentuk aslinya, model menghasilkan embedding 768 dimensi yang dapat dipersingkat menjadi 512, 256, atau 128 dimensi. Fitur ini membantu menghemat penggunaan ruang database hingga faktor enam ketika memperkecil vektor dari 768 menjadi 128 dimensi. Meskipun menawarkan penghematan, pemangkasan ukuran embedding dapat memengaruhi akurasi pencarian dalam beberapa jenis dataset. Karena alasan tersebut, pemeriksaan hasil tetap dibutuhkan sebelum memilih pengaturan akhir pada aplikasi produksi.
Manfaat Teknologi EmbeddingGemma 2 untuk Pencarian Multimedia
Dalam penerapan praktis, EmbeddingGemma 2 memiliki potensi besar untuk meningkatkan kemampuan pencarian pada perpustakaan konten digital. Untuk ilustrasi, seseorang dengan koleksi gambar yang banyak dapat menelusuri dokumentasi visual menggunakan kalimat sederhana. Tanpa harus memeriksa setiap gambar secara manual, sistem bisa menghitung kemiripan representasi teks dengan embedding gambar yang tersimpan. Mekanisme yang sama juga bisa digunakan untuk mencari konten audio berdasarkan konteks pencarian. Berkat fitur semacam ini, pengelolaan arsip digital dapat berlangsung lebih efisien apabila hasil embedding diolah secara tepat.
Di luar pengelolaan arsip, teknologi embedding ini dapat dimanfaatkan untuk pengelompokan dokumen digital. Dalam sektor pendidikan, aplikasi berpotensi menyediakan fasilitas yang menautkan informasi pembelajaran dengan rekaman audio pendukung. Pada konteks berbeda, tim yang menyimpan banyak materi digital dapat mengembangkan penelusuran berbasis makna untuk menghubungkan informasi yang berkaitan. Model tersebut juga dapat menjadi komponen dalam retrieval-augmented generation atau RAG, yakni mekanisme pengambilan informasi pendukung. Meski potensinya luas, EmbeddingGemma 2 tidak secara otomatis menghasilkan jawaban lengkap. Untuk membangun chatbot, komponen tambahan biasanya perlu diintegrasikan.
Bagaimana EmbeddingGemma 2 Mendukung Aplikasi AI Lokal
Salah satu aspek yang mendapat perhatian dari EmbeddingGemma 2 adalah kemampuannya untuk berjalan secara lokal. Dengan pendekatan ini, konten yang sedang diproses dapat diproses langsung pada perangkat pengguna. Pendekatan tersebut memberikan peluang untuk menekan kebutuhan transfer konten melalui koneksi eksternal. Untuk penggunaan pribadi, perangkat lunak pengelola dokumen dapat melakukan pencocokan data di sistem pengguna sendiri. Potensi perlindungan tersebut patut dipertimbangkan bagi pengguna yang memperhatikan privasi. Namun, penggunaan AI on-device tidak langsung menghilangkan seluruh risiko privasi.
Supaya keamanan informasi tetap terjaga, tim pengembang sebaiknya menyiapkan pengamanan penyimpanan. Informasi berupa embedding masih harus dilindungi secara aman dan terukur karena berpotensi mengungkap sebagian hubungan informasi. Di samping itu, kapasitas komputasi lokal memengaruhi efisiensi operasional model. Google menyebutkan bahwa pada implementasi yang menggunakan kuantisasi, kebutuhan RAM aktif untuk bobot model di Pixel 11 Pro bisa serendah sekitar 191 MB untuk teks saja dan kisaran 567 MB ketika seluruh modalitas digunakan. Hasil pengukuran ini bukan jaminan penggunaan memori yang sama pada setiap sistem karena perangkat keras dapat memengaruhi pemakaian sumber daya sebenarnya.
Arah Inovasi Teknologi Google untuk Pencarian Informasi Modern
Kehadiran EmbeddingGemma 2 menggambarkan arah perkembangan teknologi AI menuju model yang lebih mudah diintegrasikan. Dengan dukungan arsitektur Gemma 4 dan lisensi Apache 2.0, model ini membuka kesempatan bagi komunitas teknologi untuk mengintegrasikan representasi semantik sesuai skenario penggunaan. Dukungan terhadap teks, kode, gambar, audio, dan video turut meningkatkan kemungkinan integrasi AI dalam bermacam sistem perangkat lunak. Tidak hanya dari sisi format data, dukungan konteks hingga 8.192 token memungkinkan pemrosesan masukan yang lebih panjang dibandingkan generasi sebelumnya. Kemampuan konteks ini memberikan ruang untuk menangani kombinasi teks dan konten visual dalam batas model yang tersedia.
Di balik sejumlah keunggulannya, EmbeddingGemma 2 masih memiliki keterbatasan yang penting dipahami sebelum diterapkan pada produk nyata. Sebagai gambaran, analisis multimedia berukuran besar dapat memerlukan strategi segmentasi karena kapasitas konteks model terbatas. Selain itu, kesesuaian representasi tidak sepenuhnya menggantikan evaluasi manusia. Tim teknis sebaiknya menguji berbagai jenis masukan agar pengalaman pengguna dapat ditingkatkan. Dengan evaluasi yang tepat, model ini dapat berfungsi sebagai komponen utama bagi aplikasi penelusuran konten modern yang semakin efisien terhadap kebutuhan masyarakat digital.
Rangkuman Manfaat EmbeddingGemma 2 bagi Pengembangan AI
Peluncuran model EmbeddingGemma 2 menggambarkan bahwa inovasi pemrosesan informasi digital terus bergerak menuju representasi data multimodal yang semakin fleksibel. Melalui dukungan terhadap teks, gambar, audio, dan video dalam sistem vektor bersama, model ini memberikan kesempatan untuk mengembangkan pencarian multimedia secara semakin efisien. Struktur model yang fleksibel serta kemampuan berjalan di perangkat memberikan keuntungan bagi pengembang teknologi. Namun demikian, perencanaan integrasi tetap dibutuhkan untuk memastikan kualitas aplikasi. Bagaimana pendapat Anda, apakah teknologi AI multimodal akan mempermudah pengelolaan konten digital? Jangan ragu menyampaikan pendapat Anda mengenai manfaat yang paling menarik.