Amazon Rilis TorchNeuron agar Aplikasi PyTorch Bisa Berjalan di Chip Trainium
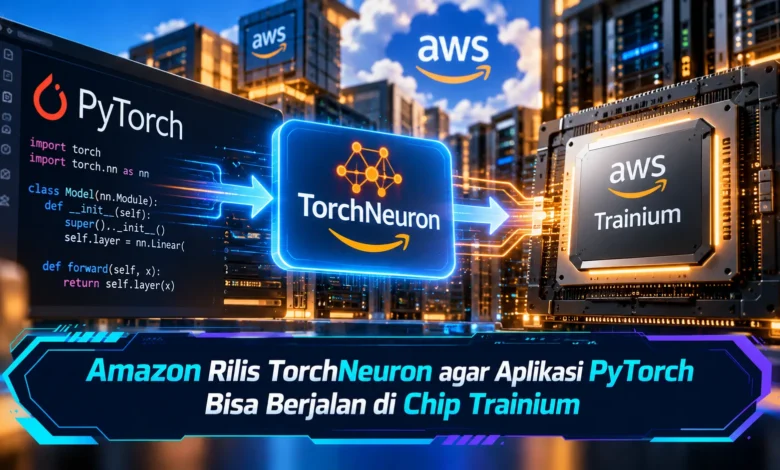
Amazon memperkenalkan TorchNeuron pada 19 Oktober 2026 sebagai langkah penting dalam memperluas penggunaan chip kecerdasan buatan AWS Trainium. Perangkat lunak ini memungkinkan pengembang menjalankan aplikasi dan model AI berbasis PyTorch pada chip Trainium tanpa harus menulis ulang sebagian besar kode yang sudah digunakan. TorchNeuron hadir dalam versi beta publik pada 20 Oktober 2026 dengan lisensi sumber terbuka Apache 2.0. Inovasi TEKNOLOGI ini menjadi perhatian karena berpotensi mengurangi ketergantungan pengembang terhadap satu platform perangkat keras. Selain membuka pilihan infrastruktur komputasi AI, Amazon juga ingin mempermudah perusahaan mengoptimalkan biaya dan meningkatkan fleksibilitas pengembangan kecerdasan buatan.
Mengenal TorchNeuron dan Inovasi Terbaru Amazon AWS
Amazon mengembangkan TorchNeuron sebagai solusi kompatibilitas antara PyTorch dan akselerator AI AWS yang bertujuan mempermudah penggunaan perangkat keras Amazon. Dengan memanfaatkan sistem ini, pengembang memiliki kesempatan menggunakan model AI yang telah dikembangkan pada infrastruktur AWS Trainium dengan penyesuaian konfigurasi yang lebih sederhana. Jika dibandingkan dengan pendekatan migrasi yang mengharuskan penyesuaian berbagai bagian kode, TorchNeuron mengintegrasikan mekanisme ekstensi resmi PyTorch agar perangkat Trainium dikenali sebagai target komputasi. Integrasi tersebut membantu memperluas alternatif infrastruktur bagi peneliti AI.
Amazon mengumumkan TorchNeuron menjelang PyTorch Conference North America yang digunakan untuk memperkenalkan teknologi ini kepada komunitas pengembang. Perangkat lunak tersebut mulai dapat digunakan dalam tahap pengujian publik pada 20 Oktober 2026 dengan lisensi Apache 2.0. Penggunaan lisensi tersebut memberikan ruang untuk kontribusi komunitas sesuai persyaratan penggunaan perangkat lunak terbuka. Sistem integrasi ini mendukung generasi chip Trainium2 dan Trainium3. Dengan cakupan tersebut, Amazon membuka kesempatan bagi pengembang untuk mencoba alternatif akselerator tanpa harus meninggalkan framework yang telah dikenal.
Cara Kerja TorchNeuron dalam Menjalankan PyTorch di Trainium
Cara kerja TorchNeuron menggunakan kemampuan perluasan perangkat PyTorch yang tersedia melalui antarmuka PrivateUse1. Komponen perangkat lunak tersebut mendukung proses integrasi akselerator dari produsen berbeda tanpa mengharuskan perubahan besar pada PyTorch. Melalui TorchNeuron, chip Trainium terdaftar melalui penamaan device neuron. Selanjutnya, pengguna, memiliki kemampuan memilih Trainium sebagai target komputasi melalui pengaturan perangkat dalam aplikasi. Rancangan perangkat lunak ini mendukung penggunaan API PyTorch yang sudah dikenal ketika menjalankan proses pelatihan.
Selain menyediakan kompatibilitas dasar, TorchNeuron menghadirkan pilihan cara menjalankan model, yaitu eager execution dan torch.compile. Ketika menggunakan eager execution, operasi PyTorch dijalankan secara langsung sehingga peneliti dapat mengevaluasi operasi model secara langsung. Sebaliknya, torch.compile digunakan untuk mengoptimalkan rangkaian operasi. Di samping kedua mode tersebut, TorchNeuron menyediakan dukungan untuk Neuron Kernel Interface atau NKI. Komponen pengembangan tersebut membantu pengembang tingkat lanjut terhadap operasi komputasi tertentu. Dengan demikian, pengguna dapat menyesuaikan strategi pengembangan berdasarkan karakteristik model AI.
Dukungan TorchNeuron untuk Model AI dan Ekosistem Hugging Face
Kemampuan yang cukup menarik dari TorchNeuron adalah dukungan terhadap berbagai alat pengembangan model. Berbagai pustaka dari Hugging Face membantu mempermudah penggunaan model pada Trainium. Berkat pengembangan bersama ekosistem PyTorch, pustaka Transformers dan Diffusers mendukung pengembangan model pada backend tersebut. Framework Transformers banyak digunakan untuk model bahasa, sedangkan Diffusers digunakan dalam pengembangan sistem generatif berbasis difusi. Dalam kebutuhan komputasi berskala besar, TorchNeuron menyediakan integrasi dengan sistem distributed training seperti Fully Sharded Data Parallelism dan tensor parallelism. Kemampuan tersebut mendukung pengaturan beban komputasi pada infrastruktur pelatihan AI berskala besar.
Kendati integrasi ekosistem semakin berkembang, TorchNeuron tidak menjamin setiap aplikasi berjalan tanpa penyesuaian. Pada tahap rilis awal, sejumlah fitur PyTorch masih membutuhkan pengembangan lanjutan. Di antara keterbatasan yang disebutkan meliputi pemrosesan sparse tensor, NestedTensor, serta pemrosesan bentuk tensor dinamis. Pada implementasi tertentu, operasi yang tidak tersedia secara langsung pada backend mungkin memerlukan penyesuaian pengembangan. Untuk menghindari kesalahan implementasi, pengguna dianjurkan membaca dokumentasi dukungan terbaru sebelum mengadopsi Trainium dalam skala besar. Langkah ini membantu mengurangi risiko gangguan secara lebih akurat.
Manfaat TorchNeuron bagi Pengembang dan Perusahaan AI
Keuntungan penting dari kehadiran TorchNeuron adalah kemudahan mengevaluasi alternatif akselerator. Pada banyak lingkungan pengembangan sebelumnya, aplikasi yang dibangun untuk akselerator tertentu dapat membutuhkan penyesuaian pustaka ketika menggunakan arsitektur komputasi baru. Dengan TorchNeuron, pengembang memiliki kesempatan menguji Trainium dengan perubahan terbatas. Pendekatan pengembangan ini berpotensi menghemat waktu eksperimen. Namun demikian, penggunaan pada sistem produksi tetap membutuhkan pengujian performa. Dengan proses tersebut, perusahaan dapat membuat keputusan berbasis kebutuhan.
Jika melihat aspek ekonomi, AWS Trainium ditawarkan sebagai alternatif akselerator AI. Ketersediaan backend PyTorch native membuka peluang perbandingan efisiensi antara Trainium dan akselerator dari penyedia berbeda. Penghematan yang mungkin diperoleh tidak dapat ditentukan dari kompatibilitas saja. Faktor seperti tarif sumber daya komputasi, durasi komputasi, pemanfaatan akselerator, serta biaya perpindahan sistem. Dalam skenario bisnis, harga komputasi yang lebih rendah belum tentu menghasilkan total biaya paling kecil apabila proses eksekusinya lebih lama. Oleh sebab itu, pengujian berdasarkan beban kerja sesungguhnya harus dilakukan sebelum mengambil keputusan.
Langkah Awal Mengembangkan AI Menggunakan Chip Amazon Trainium
Bagi pengguna yang tertarik menggunakan backend baru ini harus menggunakan perangkat komputasi yang kompatibel dengan instans AWS berbasis Trainium generasi yang sesuai. Selain perangkat keras, pengguna sebaiknya memeriksa kompatibilitas paket dengan rilis AWS Neuron yang sesuai dengan konfigurasi sistem. Backend ini didistribusikan melalui paket torch-neuronx dari saluran distribusi perangkat lunak AWS. Persiapan lingkungan pengembangan sebaiknya menggunakan panduan kompatibilitas resmi karena ketidaksesuaian versi dapat menimbulkan masalah. Setelah lingkungan siap, pengembang berpeluang menjalankan kode PyTorch melalui backend baru dan memeriksa hasilnya secara bertahap.
Setelah model berhasil dijalankan dianjurkan mengevaluasi fungsi utama model sebelum memindahkan seluruh beban produksi. Tim teknis bisa membandingkan keluaran model antara platform yang telah digunakan dan Trainium. Selain pengujian hasil, TorchNeuron mendukung analisis performa melalui torch.profiler bersama Neuron Explorer. Melalui kemampuan tersebut, pengembang memiliki kesempatan menemukan hambatan komputasi. Data pemantauan tersebut dapat digunakan untuk memperbaiki kinerja. Untuk sistem AI berskala besar, pengujian memori, pengelolaan distribusi komputasi, dan evaluasi konsumsi sumber daya tetap menjadi bagian penting.
TorchNeuron Membuka Peluang Baru bagi Ekosistem PyTorch
Peluncuran TorchNeuron menjadi perkembangan penting dalam integrasi perangkat lunak dengan akselerator AI. Dengan menghadirkan backend native PyTorch untuk Trainium2 dan Trainium3, Amazon membantu pengembang mempertahankan alur kerja ketika menjalankan model pembelajaran mesin. Dukungan eager execution, torch.compile, serta integrasi bersama alat pengembangan terbuka mendukung proses eksperimen dan produksi. Kendati memiliki potensi besar, evaluasi performa tetap harus dilakukan untuk menentukan manfaat sebenarnya. Seiring meningkatnya kebutuhan komputasi AI, TorchNeuron berpotensi memperluas pilihan pengembang. Menurut Anda, apakah kemudahan menjalankan PyTorch pada Trainium akan mendorong adopsi infrastruktur yang lebih beragam? Bagikan pendapat Anda mengenai perkembangan chip AI Amazon.