AI Inference Engine Optimization 2026 Jadi Kunci Mempercepat Pemrosesan AI di Perangkat Modern
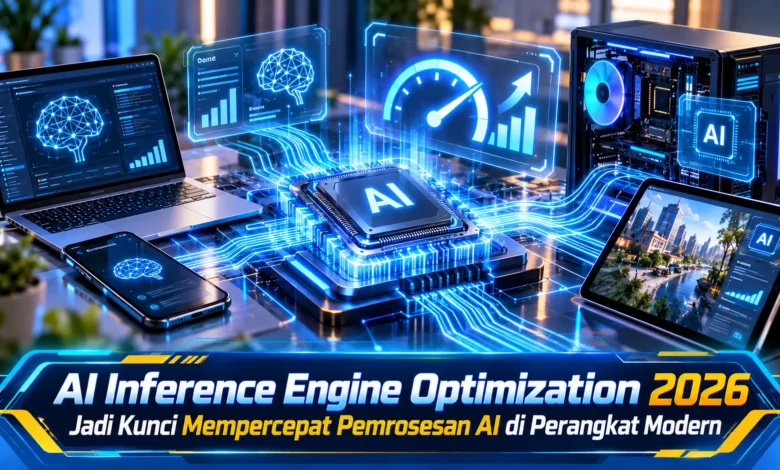
Perkembangan kecerdasan buatan pada 2026 tidak hanya berfokus pada pembuatan model yang semakin canggih, tetapi juga pada bagaimana model tersebut dapat dijalankan secara cepat dan efisien. AI Inference Engine Optimization menjadi bagian penting karena proses inference menentukan seberapa cepat perangkat menghasilkan respons setelah menerima input. Optimalisasi pada tahap ini semakin relevan ketika teknologi AI hadir di smartphone, laptop, kendaraan, perangkat wearable, kamera pintar, hingga berbagai perangkat edge yang membutuhkan respons cepat dengan konsumsi daya tetap terkendali.
Mengenal AI Inference Engine Optimization dan Fungsinya
AI Inference Engine Optimization pada dasarnya merupakan proses optimalisasi yang bertujuan mempercepat eksekusi model kecerdasan buatan pada perangkat. Ketika model telah melalui tahap training, proses inference dilakukan setiap kali sistem menerima masukan baru. Tahap inilah yang menentukan seberapa cepat teknologi AI dapat menghasilkan keluaran yang dibutuhkan pengguna.
Peningkatan inference tidak hanya berfokus pada kecepatan menjalankan model. Pengembang juga perlu mempertimbangkan penggunaan memori, konsumsi energi, latensi, kapasitas perangkat, serta karakteristik hardware yang tersedia. Keseimbangan berbagai faktor tersebut penting karena model yang sangat cepat belum tentu ideal apabila membutuhkan daya atau memori terlalu besar.
Kebutuhan Inference Cepat Meningkat di Perangkat Modern
Semakin banyak fitur AI yang berjalan langsung pada perangkat membuat kecepatan inference menjadi semakin penting. Kemampuan seperti analisis gambar, terjemahan, pengenalan suara, pengeditan konten, AI assistant, serta pemrosesan sensor memerlukan waktu respons yang singkat. Apabila inference membutuhkan waktu terlalu lama, jeda respons dapat mengganggu pengalaman ketika menggunakan perangkat.
Kecepatan juga menjadi penting untuk aplikasi yang membutuhkan keputusan hampir secara real time. Perangkat modern dapat memperoleh informasi dari kamera, mikrofon, sensor pergerakan, maupun komponen lainnya secara berkelanjutan. Optimalisasi inference engine memungkinkan data diproses dengan latensi lebih rendah sehingga teknologi dapat menghasilkan tindakan atau informasi dengan lebih cepat.
Quantization Menjadi Teknik Penting untuk Mempercepat AI
Salah satu teknik yang banyak digunakan untuk meningkatkan efisiensi inference adalah quantization. Teknik tersebut bekerja dengan menggunakan representasi angka berpresisi lebih rendah sehingga penggunaan memori maupun beban komputasi dapat ditekan. Dalam implementasi yang sesuai, model dapat menjadi lebih ringan dan lebih cepat dijalankan tanpa harus mengubah fungsi utamanya.
Meski menawarkan keuntungan, penurunan presisi tetap harus diuji sebab optimalisasi berlebihan berpotensi memengaruhi akurasi maupun kualitas keluaran. Pengembang perlu menemukan keseimbangan antara ukuran model, kecepatan inference, penggunaan energi, dan kualitas output. Oleh sebab itu, evaluasi langsung pada hardware tujuan menjadi tahapan penting sebelum teknologi diterapkan lebih luas.

Perangkat Modern Mengandalkan Akselerasi Khusus untuk AI
Optimalisasi software akan semakin efektif apabila dapat memanfaatkan kemampuan hardware secara tepat. Perangkat modern dapat memiliki CPU, GPU, NPU, maupun akselerator khusus yang memiliki karakteristik berbeda dalam menjalankan beban kerja AI. Inference engine harus mengoptimalkan eksekusi operasi agar sumber daya komputasi yang tersedia dapat dimanfaatkan secara maksimal.
NPU memperoleh perhatian karena komponen tersebut dirancang untuk memproses sejumlah beban kerja AI dengan penggunaan sumber daya yang efisien. Walaupun hardware memiliki kemampuan tinggi, hasil akhirnya tetap ditentukan oleh model, inference engine, compiler, driver, memori, dan optimalisasi sistem secara keseluruhan. Inilah alasan optimalisasi teknologi AI membutuhkan pendekatan lintas software dan hardware, bukan sekadar mengandalkan satu komponen dengan spesifikasi tinggi.
Efisiensi Daya Menjadi Tantangan Pemrosesan AI Lokal
On device AI dapat memberikan keuntungan berupa waktu respons singkat serta mengurangi ketergantungan pada layanan cloud dalam tugas tertentu. Namun, smartphone, laptop, wearable, dan perangkat edge memiliki batas konsumsi energi serta kapasitas pendinginan. Proses inference yang membutuhkan sumber daya besar dapat menguras baterai dan meningkatkan temperatur perangkat sehingga kenyamanan berkurang.
Optimalisasi inference engine bertujuan menekan beban komputasi yang tidak diperlukan sambil menggunakan hardware secara lebih efektif. Berbagai teknik mulai dari manajemen memori, graph optimization, operator fusion, quantization, hingga penjadwalan workload dapat digunakan untuk meningkatkan efisiensi. Tujuannya adalah menghadirkan teknologi AI dengan respons yang cepat sambil mempertahankan penggunaan sumber daya yang terkontrol.
Inference Cepat Membutuhkan Optimalisasi dari Model hingga Runtime
Kecepatan AI tidak hanya ditentukan oleh seberapa kuat prosesor yang digunakan. Desain model, tipe operasi, skala parameter, representasi data, sistem memori, compiler, dan runtime dapat memengaruhi kecepatan inference. Dengan demikian, optimalisasi teknologi AI perlu mempertimbangkan keseluruhan pipeline dari model hingga hardware yang menjalankannya.
Model dapat disesuaikan berdasarkan karakteristik hardware tempat teknologi tersebut akan dijalankan. Sistem yang berjalan pada server bertenaga besar mungkin memerlukan strategi berbeda dibandingkan model untuk ponsel atau perangkat wearable. Strategi berbasis karakteristik perangkat dapat membantu menyeimbangkan kualitas keluaran, performa, kebutuhan daya, serta kapasitas memori.
Arah AI Inference Engine Optimization pada Perangkat Modern
AI Inference Engine Optimization 2026 menjadi bagian penting dalam perkembangan AI karena kemampuan model yang tinggi perlu didukung proses eksekusi yang cepat dan efisien. Pendekatan melalui quantization, manajemen memori, graph optimization, operator fusion, compiler, runtime, serta pemanfaatan hardware khusus dapat meningkatkan efisiensi pemrosesan. Peran inference yang efisien semakin besar ketika teknologi kecerdasan buatan hadir langsung di smartphone, komputer, wearable, kendaraan, serta berbagai perangkat edge. Dengan mengoptimalkan model, perangkat lunak, dan hardware secara menyeluruh, teknologi AI dapat menghasilkan performa lebih cepat dengan konsumsi sumber daya yang lebih terkendali. Pembaca dapat terus mengikuti perkembangan teknologi inference berikutnya dan mengamati bagaimana optimalisasi ini memengaruhi kemampuan AI pada perangkat yang digunakan sehari hari.