Amazon Luncurkan TorchNeuron agar Kode PyTorch Lebih Mudah Berjalan di Chip Trainium
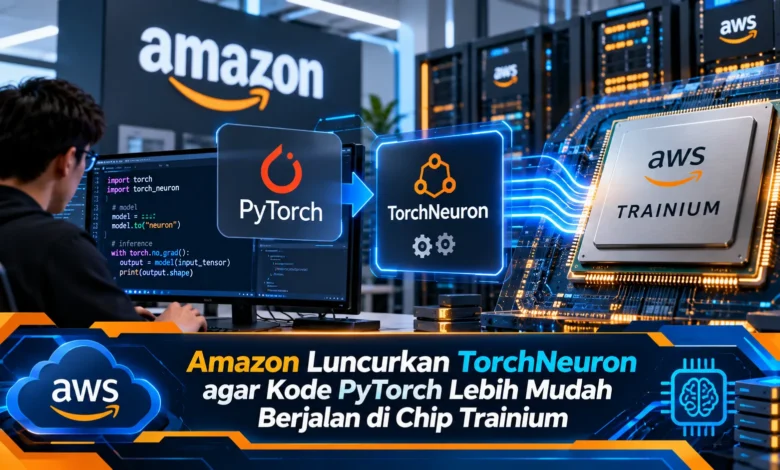
Amazon Web Services (AWS) resmi meluncurkan TorchNeuron dalam versi public beta pada 20 Oktober 2026 sebagai langkah penting untuk menyederhanakan pengembangan kecerdasan buatan. Teknologi open source ini memungkinkan pengembang menjalankan kode PyTorch secara lebih langsung pada chip AWS Trainium tanpa perlu melakukan penulisan ulang aplikasi secara menyeluruh. Kehadiran TorchNeuron memberikan pilihan baru bagi peneliti, perusahaan teknologi, dan pengembang model AI yang membutuhkan infrastruktur komputasi berkinerja tinggi. Melalui integrasi dengan PyTorch, Amazon berupaya mengurangi hambatan penggunaan akselerator AI sekaligus memperluas fleksibilitas pengembangan model machine learning di lingkungan cloud.
Mengenal Amazon TorchNeuron dan Perannya dalam Pengembangan AI
AWS menghadirkan TorchNeuron sebagai perangkat lunak penghubung antara framework AI dan akselerator komputasi yang dirancang untuk mendukung pemrosesan model AI menggunakan AWS Trainium. Sebelumnya, pemindahan model AI ke perangkat keras berbeda sering melibatkan proses integrasi tambahan. Kondisi tersebut berpotensi memperpanjang waktu pengembangan. Dengan hadirnya TorchNeuron, pengembang dapat memanfaatkan aplikasi AI berbasis PyTorch melalui pendekatan pemrosesan yang lebih langsung. Kemampuan ini membuka peluang baru bagi komunitas machine learning.
AWS menyediakan TorchNeuron dalam bentuk public beta dengan kode sumber terbuka. Dalam ketersediaan saat ini, dukungan perangkat keras mencakup Amazon EC2 Trainium2 dan Trainium3. Perangkat keras AI tersebut dirancang untuk menangani kebutuhan komputasi pembelajaran mesin yang memerlukan sumber daya besar. Dalam ekosistem perangkat lunaknya, AWS memasukkan TorchNeuron sebagai backend baru pada platform perangkat lunak Neuron. Keterpaduan sistem tersebut menyediakan dukungan bagi pelatihan model AI yang lebih fleksibel. Walaupun membawa pembaruan penting, status beta berarti pengembang tetap perlu melakukan evaluasi sebelum menerapkannya dalam sistem operasional penting.
Mekanisme TorchNeuron untuk Mempermudah Penggunaan Akselerator AI
Dalam mekanisme operasionalnya, TorchNeuron menggunakan mekanisme backend bawaan PyTorch yang dikenal sebagai PrivateUse1. Arsitektur ini memungkinkan Trainium dikenali sebagai perangkat komputasi tanpa memerlukan framework pemrograman yang sepenuhnya berbeda. Untuk menggambarkan penerapannya, model PyTorch dengan pengaturan perangkat CUDA dapat menggunakan penanda perangkat neuron. Perubahan tersebut dapat dilakukan dengan mengubah tujuan tensor dari CUDA ke neuron. Dengan cara ini, sebagian besar alur pemrograman standar tetap dapat dipertahankan. Walaupun begitu, dukungan seluruh komponen model tidak boleh langsung diasumsikan.
TorchNeuron menyediakan kemampuan eksekusi langsung yang membantu pengembang melakukan eksperimen secara interaktif. Pendekatan eksekusi tersebut mendukung proses debugging model karena peneliti bisa mengevaluasi hasil perhitungan langsung. Di luar pemrosesan langsung, TorchNeuron mendukung penggunaan torch.compile untuk mendukung peningkatan performa melalui kompilasi. Pada penggunaan torch.compile, sejumlah operasi dapat dianalisis bersama sebelum dijalankan pada akselerator. Dukungan eager dan kompilasi memungkinkan pemilihan pendekatan sesuai kebutuhan. Tim teknis berkesempatan menentukan pendekatan pemrosesan yang paling relevan.
Dukungan Neuron Kernel Interface untuk Optimasi Model AI
Tidak hanya menyediakan dukungan backend native, TorchNeuron juga terhubung dengan Neuron Kernel Interface atau NKI. Komponen pengembangan tersebut memungkinkan pembuatan kernel khusus pada arsitektur perangkat keras Trainium. Dalam pengembangan model besar, operator standar tidak selalu memberikan performa paling optimal. Berkat dukungan pemrograman kernel, pengembang berpengalaman dapat merancang kernel komputasi dengan karakteristik khusus. Untuk contoh penerapan, operasi tensor tertentu dapat dianalisis untuk menemukan hambatan performa. Namun pada penerapan nyata, keuntungan performa harus diukur melalui pengujian.
Untuk membantu proses evaluasi, AWS menghadirkan perangkat analisis Neuron Explorer yang membantu menganalisis aktivitas pemrosesan. Dengan menggunakan data dari torch.profiler, pengembang dapat melihat aktivitas komputasi hingga asal instruksi yang dijalankan. Fasilitas tersebut mempermudah identifikasi bottleneck. Dalam praktik pengembangan, ketika model mengalami keterlambatan, pengembang dapat meninjau profil aktivitas. Informasi tersebut kemudian menjadi dasar pengoptimalan kode. Dengan demikian, TorchNeuron juga mendukung pekerjaan optimasi lanjutan.
Keunggulan Integrasi PyTorch dengan AWS Trainium
Keuntungan penting yang ditawarkan TorchNeuron adalah penyederhanaan adaptasi kode PyTorch. Dalam pengembangan kecerdasan buatan, peneliti membutuhkan proses evaluasi yang panjang untuk memeriksa hasil komputasi. Ketika migrasi memerlukan adaptasi sistem menyeluruh, proses eksperimen berpotensi melambat. Backend baru ini dirancang untuk mengurangi kompleksitas migrasi tersebut dengan mendukung penggunaan kode yang sudah tersedia. Hasilnya, pengembang berpotensi menghemat waktu adaptasi. Meski begitu, keuntungan waktu tidak selalu sama pada setiap proyek.
Dalam lingkungan bisnis berbasis kecerdasan buatan, TorchNeuron memperluas opsi komputasi model melalui AWS Trainium. Pilihan tersebut memungkinkan organisasi mengevaluasi efisiensi proses inferensi. Pada implementasi skala industri, efisiensi penggunaan akselerator sangat diperhatikan. Tim operasional sebaiknya memeriksa harga penggunaan instance, kemampuan penskalaan, serta biaya pengelolaan sistem. Dengan akses PyTorch yang lebih mudah, evaluasi penggunaan Trainium dapat dilakukan lebih cepat. Kendati akselerator Trainium ditujukan bagi komputasi yang efisien, keuntungan finansial harus dihitung berdasarkan beban kerja.
Peluang Pemanfaatan TorchNeuron dalam Pengembangan Model AI Modern
Peluncuran integrasi Trainium terbaru membuka peluang untuk sejumlah jenis aplikasi kecerdasan buatan. Contoh penggunaan yang relevan adalah pemrosesan model AI generatif berbasis teks. Model seperti ini memerlukan pemrosesan matriks yang kompleks. Backend tersebut menyediakan kompatibilitas dengan API PyTorch untuk komputasi terdistribusi seperti DistributedDataParallel, FullyShardedDataParallel, dan DTensor. Berkat integrasi tersebut, organisasi dapat mengembangkan strategi distribusi model pada beberapa perangkat akselerator. Meski membuka peluang implementasi, efisiensi penskalaan harus diperiksa secara langsung.
Di luar pengembangan LLM, TorchNeuron dapat mendukung pekerjaan pengembangan sistem pembelajaran mesin untuk data multimedia. Komunitas peneliti yang mengembangkan model melalui library AI populer berpeluang mencoba backend TorchNeuron melalui integrasi PyTorch native. Potensi penerapan ini memiliki relevansi pada beragam bidang seperti robotika dan sistem otonom, pemodelan data kompleks, serta pembuatan sistem kecerdasan buatan khusus. Perlu diperhatikan, tingkat kompatibilitas tidak selalu identik pada semua aplikasi. Dengan mempertimbangkan hal tersebut, pengembang tetap perlu menguji akurasi hasil sebelum menerapkan aplikasi secara luas.
Penutup: Dampak TorchNeuron bagi Masa Depan Komputasi AI
Kehadiran backend PyTorch native dari AWS menjadi langkah penting dalam memperluas pilihan akselerator AI. Dengan menghadirkan integrasi API PyTorch, pengembang dapat mencoba AWS Trainium dengan penyesuaian kode yang lebih sedikit. Kemampuan eksekusi langsung, torch.compile, serta Neuron Kernel Interface mendukung berbagai kebutuhan komputasi model. Walaupun masih dalam tahap public beta, TorchNeuron memiliki potensi untuk mempermudah penggunaan akselerator AI. Seiring pertumbuhan TEKNOLOGI kecerdasan buatan, fleksibilitas memilih infrastruktur semakin bernilai. Menurut Anda, apakah kemudahan kompatibilitas akan menjadi faktor utama dalam persaingan akselerator kecerdasan buatan? Mari sampaikan pandangan tentang perkembangan TorchNeuron.