Local LLM Runtime Makin Populer di 2026, AI Kini Bisa Berjalan Cepat Tanpa Bergantung pada Cloud
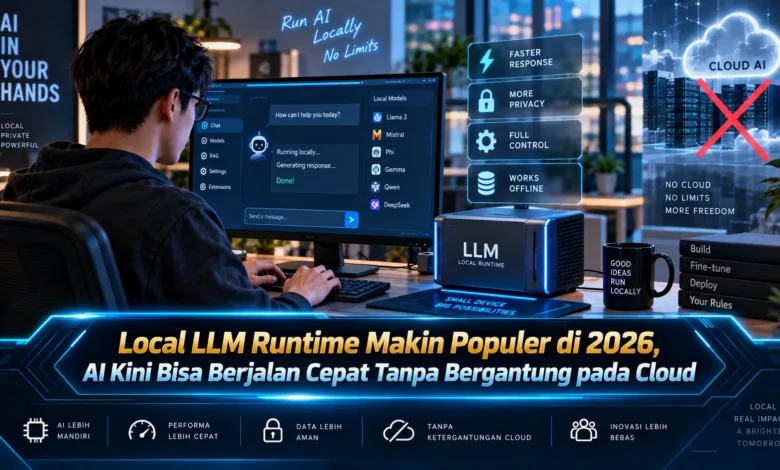
Perkembangan kecerdasan buatan pada 2026 semakin menarik dengan meningkatnya penggunaan Local LLM Runtime, yaitu pendekatan yang memungkinkan model bahasa dijalankan langsung pada komputer, laptop, workstation, atau perangkat lokal tanpa harus selalu mengirim proses ke server cloud. Kemajuan perangkat keras dan optimasi model membuat TEKNOLOGI AI lokal semakin praktis untuk berbagai kebutuhan, mulai dari menulis, merangkum dokumen, membantu pemrograman, hingga mengolah informasi pribadi dengan kontrol data yang lebih besar.
AI Lokal Semakin Populer Berkat Perkembangan Local LLM Runtime
Perkembangan Local LLM Runtime semakin menarik perhatian karena pengguna menginginkan sistem AI yang mampu berjalan langsung tanpa harus terus terhubung dengan layanan cloud. Dengan menjalankan model secara langsung di perangkat, proses permintaan dan respons dapat dilakukan di dalam sistem lokal sehingga sebagian pekerjaan tidak perlu dikirim menuju pusat data jarak jauh. Perubahan ini membuat TEKNOLOGI AI semakin fleksibel karena pengguna memiliki pilihan antara menggunakan layanan cloud atau menjalankan model sesuai kemampuan perangkat yang tersedia.
Popularitas Local LLM Runtime juga meningkat berkat model yang semakin ringan dan optimal untuk dijalankan pada komputer dengan spesifikasi yang tidak selalu berada di kelas pusat data. Teknik optimasi seperti quantization membantu mengurangi kebutuhan memori sehingga model berukuran besar dapat dipadatkan menjadi format yang lebih sesuai untuk penggunaan lokal. Perkembangan tersebut membuat AI lokal mulai berpindah dari lingkungan eksperimen menuju penggunaan praktis dalam aktivitas sehari hari.

Kecepatan Menjadi Salah Satu Keunggulan Local LLM Runtime
Salah satu alasan AI lokal terasa responsif adalah karena sebagian proses berlangsung langsung pada perangkat tanpa membutuhkan pengiriman data menuju pusat komputasi jarak jauh. Ketika perangkat memiliki prosesor, GPU, NPU, atau memori yang memadai, model dapat menghasilkan respons dengan latensi yang rendah untuk berbagai tugas. Performa sebenarnya tetap dipengaruhi oleh ukuran model, konteks yang diproses, tingkat kompresi, runtime, serta spesifikasi perangkat.
Pemrosesan di perangkat memungkinkan beberapa fungsi AI tetap digunakan ketika jaringan internet mengalami gangguan maupun keterbatasan. Pengguna yang sering bekerja dengan dokumen, kode, maupun catatan dapat menjalankan model tanpa harus bergantung pada kondisi jaringan selama seluruh komponen yang diperlukan sudah tersedia pada perangkat. Karakteristik tersebut membuat TEKNOLOGI Local LLM menarik bagi pengguna yang mengutamakan fleksibilitas sekaligus ketersediaan sistem AI kapan saja.
Local LLM Memberikan Kontrol Data yang Lebih Besar
Tidak hanya menawarkan kecepatan, Local LLM Runtime juga menarik dari sisi privasi sebab informasi dapat tetap diproses di dalam perangkat lokal. Dokumen internal, catatan pribadi, kode program, atau informasi lainnya dapat diproses secara lokal apabila sistem dikonfigurasi tanpa mengirimkan data kepada layanan eksternal. Pemrosesan di perangkat memungkinkan pengguna memiliki kontrol lebih jelas terhadap tempat data berada serta aplikasi yang diperbolehkan membacanya.
Namun penggunaan lokal tidak otomatis membuat seluruh sistem sepenuhnya aman karena keamanan tetap dipengaruhi oleh konfigurasi perangkat, aplikasi, jaringan, model, dan kebiasaan pengguna. Komputer yang terkena malware maupun memiliki pengamanan akun yang lemah masih dapat membuat informasi lokal berada dalam risiko. Karena itu perkembangan TEKNOLOGI AI lokal tetap perlu disertai kebiasaan keamanan seperti pembaruan sistem, enkripsi, perlindungan akun, dan pengelolaan izin aplikasi.
GPU NPU dan Memori Menjadi Penggerak Local LLM Runtime
Kemajuan hardware berperan besar dalam pertumbuhan Local LLM sebab perangkat modern mulai dilengkapi kemampuan komputasi yang lebih sesuai untuk menjalankan model AI. Keberadaan GPU membantu mempercepat komputasi model sementara NPU mulai digunakan untuk menjalankan beban AI dengan konsumsi sumber daya yang lebih terarah. Jumlah RAM maupun memori GPU menjadi faktor penting sebab model dan konteks perlu ditempatkan dalam memori ketika proses inferensi dilakukan.
Pengguna tidak selalu membutuhkan perangkat kelas tertinggi karena model yang lebih kecil dan teroptimasi dapat memberikan hasil yang memadai untuk berbagai pekerjaan ringan hingga menengah. Menyesuaikan ukuran model dengan kemampuan hardware menjadi langkah penting supaya penggunaan AI lokal tetap cepat dan stabil. Cara ini menjadikan TEKNOLOGI AI lokal lebih mudah diakses karena model dapat disesuaikan dengan kemampuan komputer masing masing.
Local LLM Cocok untuk Produktivitas Coding dan Pengolahan Dokumen
Penggunaan Local LLM dapat mencakup aktivitas seperti meringkas dokumen, menyusun teks, memahami catatan, mencari informasi pada file, dan membantu proses coding. Pengembang juga dapat menghubungkan model dengan aplikasi lokal sehingga AI menjadi bagian dari alur kerja tanpa seluruh informasi harus dikirim menuju layanan eksternal. Pendekatan tersebut memungkinkan lahirnya aplikasi AI yang lebih mandiri serta memberikan kendali lebih luas terhadap informasi yang digunakan.
Di organisasi, Local LLM dapat mendukung pencarian data internal, penyusunan informasi, maupun otomatisasi pekerjaan selama penggunaan mengikuti kebijakan keamanan. AI dapat dihubungkan dengan data internal atau mekanisme pencarian lokal sehingga jawaban dapat disesuaikan dengan informasi organisasi. Pemanfaatan seperti ini memperlihatkan bagaimana TEKNOLOGI Local LLM dapat berkembang dari sekadar chatbot menjadi komponen produktivitas yang terintegrasi dengan berbagai sistem.
Cloud dan Local LLM Bisa Saling Melengkapi
Popularitas AI lokal bukan berarti komputasi cloud akan kehilangan fungsinya sebab local runtime dan cloud memiliki karakteristik yang berbeda. Pemrosesan cloud tetap relevan bagi model dengan kebutuhan sumber daya besar sementara Local LLM menawarkan keuntungan untuk tugas yang dapat ditangani langsung di perangkat. Keputusan menggunakan lokal atau cloud dapat disesuaikan dengan karakter tugas, kapasitas hardware, kebutuhan keamanan data, dan faktor biaya.
Sistem hybrid dapat menjadi pilihan populer dengan menjalankan proses ringan di perangkat sementara tugas kompleks diproses menggunakan infrastruktur cloud. Strategi hybrid memungkinkan pengguna memperoleh keseimbangan antara respons cepat, privasi lokal, serta kemampuan komputasi cloud. Kondisi tersebut memperlihatkan bahwa TEKNOLOGI AI masa depan berpotensi menggunakan kombinasi antara komputasi perangkat dan infrastruktur cloud secara lebih fleksibel.
Kesimpulan AI Semakin Cepat Tanpa Ketergantungan Penuh pada Cloud
Local LLM Runtime menjadi salah satu perkembangan menarik pada 2026 karena kecerdasan buatan semakin memungkinkan untuk dijalankan langsung di komputer tanpa harus selalu bergantung pada server cloud. Keunggulan dalam hal kecepatan, privasi, akses offline, dan fleksibilitas menjadikan Local LLM semakin menarik untuk kebutuhan pribadi maupun profesional. Peningkatan kemampuan hardware dan efisiensi model membantu membawa Local LLM menuju lebih banyak jenis komputer serta skenario penggunaan. Jika tren ini terus berkembang, TEKNOLOGI Local LLM dapat menjadi salah satu fondasi penting AI modern sekaligus menawarkan kebebasan lebih besar dalam menentukan lokasi pemrosesan.