Cerebras Gabungkan GPU dan Chip Skala Wafer untuk Mempercepat Inferensi AI
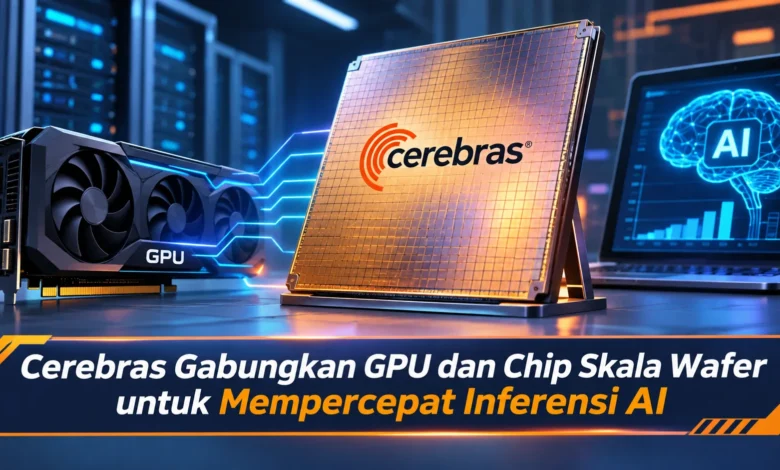
Perkembangan teknologi kecerdasan buatan memasuki babak baru setelah Cerebras memperkenalkan pendekatan yang menggabungkan GPU dengan chip berskala wafer untuk mempercepat proses inferensi AI. Melalui pengumuman pada 17 November 2026, perusahaan tersebut menjelaskan bagaimana pembagian tugas komputasi dapat meningkatkan kapasitas pemrosesan tanpa mengorbankan kecepatan pembuatan respons. Inovasi ini menjadi perhatian karena kebutuhan layanan AI terus meningkat, terutama untuk chatbot, asisten pemrograman, dan sistem otomatis yang memerlukan jawaban cepat. Dengan memanfaatkan keunggulan dua jenis perangkat keras, Cerebras berupaya menghadirkan infrastruktur AI yang lebih efisien, responsif, dan mampu melayani lebih banyak pengguna secara bersamaan.
Inovasi Cerebras Menggabungkan Dua Jenis Pemrosesan AI
Perusahaan teknologi Cerebras memperkenalkan arsitektur inferensi yang lebih terarah melalui penggabungan GPU dengan chip skala wafer. Inovasi perangkat keras tersebut dikembangkan untuk memperbaiki efektivitas layanan kecerdasan buatan. Pada penerapan teknologi tersebut, GPU menangani pemrosesan masukan pengguna, sedangkan chip Cerebras difokuskan pada pembuatan keluaran. Pembagian pekerjaan ini mengurangi kebutuhan menggunakan satu jenis prosesor untuk seluruh tahapan. Hasilnya, beban kerja sistem dapat dikelola secara lebih efisien tanpa memaksakan seluruh proses pada satu jenis chip.
Perkembangan tersebut menarik perhatian industri karena penggunaan model generatif semakin meluas. Berbagai aplikasi modern membutuhkan respons dalam waktu singkat, terutama ketika memproses permintaan dalam jumlah besar. Cerebras menjelaskan bahwa pendekatan tersebut telah diuji melalui penerapan produksi. Menurut hasil pengujian internal Cerebras, konfigurasi tersebut menghasilkan throughput per megawatt lima kali lebih tinggi dibandingkan pengaturan inferensi CS-3 sebelumnya. Angka tersebut menggambarkan hasil pada konfigurasi tertentu, bukan kepastian peningkatan serupa pada seluruh aplikasi AI.

Cara Kerja GPU dan Chip Skala Wafer dalam Sistem Cerebras
Teknologi yang diperkenalkan Cerebras dikenal sebagai disaggregated inference. Secara sederhana, proses inferensi model bahasa dapat dibagi menjadi dua proses penting, yaitu prefill dan decode. Tahap prefill memproses konteks permintaan sebelum jawaban dihasilkan. Pada tahap selanjutnya, decode menghasilkan token keluaran secara bertahap. Kedua tahapan tersebut memiliki karakteristik kebutuhan perangkat keras berbeda. Melalui pembagian tanggung jawab tersebut, pemanfaatan akselerator dapat disesuaikan dengan karakter pekerjaan.
Pada penerapan nyata arsitektur tersebut, GPU AMD Instinct menangani pemrosesan prompt awal, sedangkan sistem Cerebras CS-3 melaksanakan tahap decode. Pemisahan tersebut membantu chip berskala wafer mengalokasikan lebih banyak kapasitas untuk menghasilkan token. Ketika tahap prefill telah dilakukan, keadaan internal model yang diperlukan dikirimkan kepada akselerator tahap berikutnya. Mekanisme komunikasi tersebut membutuhkan koneksi dengan latensi rendah. Apabila komunikasi berjalan optimal, keuntungan pembagian tugas dapat dipertahankan meskipun melibatkan perangkat keras dengan arsitektur berlainan.
Keunggulan Memori Chip Wafer-Scale Engine untuk Generasi Token
Karakteristik menonjol dari chip Wafer-Scale Engine adalah penempatan sumber daya komputasi serta SRAM dalam satu wafer. Berbeda dari rancangan prosesor konvensional, desain Cerebras menyediakan jalur akses data internal dengan bandwidth sangat besar. Keunggulan tersebut memiliki peran besar pada tahap decode karena setiap token baru bergantung pada informasi sebelumnya. Dalam proses tersebut, sistem melakukan akses memori pada setiap langkah generasi. Bandwidth memori yang tinggi membantu mengurangi hambatan pemrosesan, terutama pada layanan dengan kebutuhan respons interaktif.
Walaupun memiliki keunggulan tersebut, chip skala wafer tidak otomatis lebih unggul untuk setiap jenis pekerjaan. Tahap prefill misalnya, dapat memanfaatkan kemampuan operasi matriks secara masif. Prosesor grafis berperforma tinggi dirancang menangani banyak operasi paralel. Atas dasar kebutuhan yang berbeda itu, Cerebras memilih pendekatan yang menggabungkan kemampuan kedua perangkat. Strategi ini menunjukkan bahwa kemajuan teknologi AI tidak selalu bergantung pada satu prosesor tercepat, termasuk pengelolaan memori dan aliran data antarprosesor.
Peluang Penghematan Sumber Daya Melalui Infrastruktur Inferensi Hybrid
Salah satu tantangan besar industri AI adalah besarnya konsumsi daya ketika permintaan pengguna bertambah. Berbagai aktivitas pemrosesan model membutuhkan energi untuk menghasilkan respons. Ketika jumlah permintaan meningkat, penyedia infrastruktur harus memastikan kapasitas sistem tetap memadai. Untuk menjawab tantangan tersebut, peningkatan throughput per megawatt menjadi indikator penting. Dengan mengoptimalkan dua tahap inferensi secara terpisah, Cerebras menargetkan peningkatan jumlah respons yang dapat diproses.
Bagi operator pusat data, pendekatan tersebut dapat membuka peluang efisiensi operasional. Walau begitu, efektivitas biaya keseluruhannya tetap perlu dihitung berdasarkan kondisi nyata. Biaya pembelian perangkat, kebutuhan sistem pendingin, kompleksitas jaringan, serta kebutuhan dukungan teknis harus diperhitungkan dalam evaluasi ekonomi. Oleh sebab itu, peningkatan performa per megawatt tidak boleh langsung disamakan dengan penghematan biaya total. Pengujian sesuai beban kerja nyata diperlukan untuk memastikan manfaat investasi.
Pengaruh Inferensi Berkecepatan Tinggi terhadap Aplikasi Digital
Kemampuan menghasilkan respons AI secara cepat berpotensi memberikan manfaat pada berbagai layanan digital. Asisten pemrograman berbasis AI, misalnya, harus menangani rangkaian permintaan teknis yang saling berkaitan. Ketika pengguna melakukan revisi kode, latensi rendah dapat membuat proses interaksi terasa lebih alami. Peluang peningkatan pengalaman tersebut berpotensi membantu platform percakapan otomatis. Meskipun demikian, keandalan keluaran tidak hanya dipengaruhi kecepatan perangkat. Pemrosesan dengan latensi rendah belum tentu menghilangkan kesalahan respons AI.
Tidak terbatas pada layanan tanya jawab, arsitektur pemrosesan AI yang responsif dapat membantu aplikasi otomatis berbasis model bahasa. Sistem kecerdasan buatan berbasis agen mungkin menggunakan banyak permintaan inferensi dalam satu alur aktivitas. Contohnya, sistem dapat membaca instruksi, memeriksa informasi, lalu menyiapkan hasil. Jika latensi inferensi dapat ditekan, durasi penyelesaian tugas berpeluang menjadi lebih singkat. Walaupun demikian, performa keseluruhan juga ditentukan oleh jumlah tahapan dan kebutuhan verifikasi.
Masa Depan Penggabungan GPU dan Chip Skala Wafer
Pengembangan sistem komputasi gabungan oleh Cerebras menegaskan perlunya rancangan infrastruktur yang sesuai kebutuhan dalam menjawab peningkatan permintaan komputasi modern. Dengan menempatkan prefill pada GPU dan memanfaatkan Wafer-Scale Engine untuk decode, infrastruktur berpotensi menangani lebih banyak permintaan. Walaupun pengujian produksi memperlihatkan keuntungan efisiensi, manfaatnya harus dinilai berdasarkan kebutuhan operasional nyata. Bagaimana pandangan Anda, apakah penggunaan arsitektur komputasi hybrid akan menjadi pendekatan penting bagi pusat data masa depan? Bagikan pendapat Anda mengenai perkembangan ini.