Local LLM Runtime Makin Populer di 2026, AI Kini Bisa Berjalan Cepat Tanpa Bergantung pada Cloud
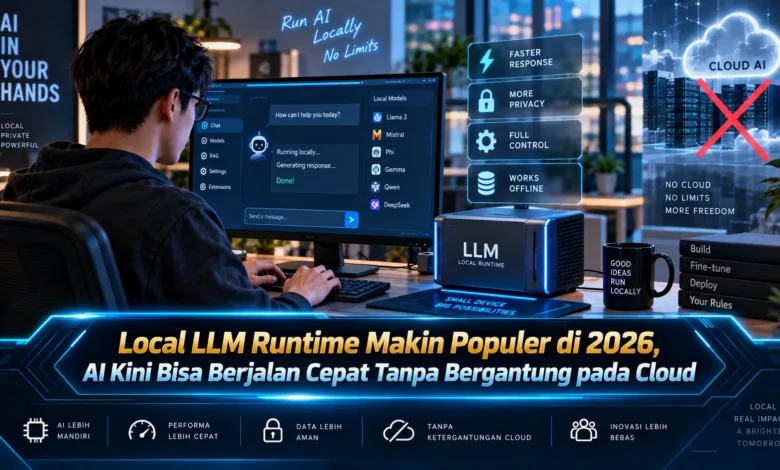
Perkembangan kecerdasan buatan pada 2026 semakin menarik dengan meningkatnya penggunaan Local LLM Runtime, yaitu pendekatan yang memungkinkan model bahasa dijalankan langsung pada komputer, laptop, workstation, atau perangkat lokal tanpa harus selalu mengirim proses ke server cloud. Kemajuan perangkat keras dan optimasi model membuat TEKNOLOGI AI lokal semakin praktis untuk berbagai kebutuhan, mulai dari menulis, merangkum dokumen, membantu pemrograman, hingga mengolah informasi pribadi dengan kontrol data yang lebih besar.
AI Lokal Semakin Populer Berkat Perkembangan Local LLM Runtime
Perkembangan Local LLM Runtime semakin menarik perhatian karena pengguna menginginkan sistem AI yang mampu berjalan langsung tanpa harus terus terhubung dengan layanan cloud. Dengan menjalankan model secara langsung di perangkat, proses permintaan dan respons dapat dilakukan di dalam sistem lokal sehingga sebagian pekerjaan tidak perlu dikirim menuju pusat data jarak jauh. Perubahan ini membuat TEKNOLOGI AI semakin fleksibel karena pengguna memiliki pilihan antara menggunakan layanan cloud atau menjalankan model sesuai kemampuan perangkat yang tersedia.
Pertumbuhan penggunaan AI lokal turut dipengaruhi oleh hadirnya model yang semakin efisien sehingga dapat dijalankan pada perangkat dengan kemampuan komputasi yang lebih beragam. Metode seperti quantization dapat menurunkan kebutuhan memori sehingga model dapat dijalankan dalam format yang lebih efisien pada perangkat lokal. Hasilnya, AI lokal tidak lagi hanya menjadi eksperimen bagi pengguna teknis tetapi mulai berkembang menjadi pilihan nyata untuk kebutuhan produktivitas sehari hari.
Mengapa Local LLM Bisa Berjalan Lebih Cepat Tanpa Cloud
Salah satu daya tarik Local LLM Runtime adalah kemampuan memberikan respons tanpa harus menunggu perjalanan data dari perangkat menuju server cloud lalu kembali lagi kepada pengguna. Jika komputer memiliki CPU, GPU, NPU, serta kapasitas memori yang sesuai, model dapat memproses banyak tugas dengan waktu respons yang relatif cepat. Kecepatan AI lokal tetap ditentukan oleh sejumlah faktor seperti ukuran model, panjang input, optimasi perangkat lunak, jenis quantization, dan kemampuan hardware.
AI lokal dapat memberikan keuntungan tambahan karena sejumlah pekerjaan tetap dapat dilakukan meskipun koneksi internet tidak stabil. Pengguna dapat memproses dokumen, kode, atau informasi lainnya secara lokal selama model dan runtime telah tersimpan di perangkat meskipun akses internet sedang terbatas. Kemampuan tersebut menjadikan TEKNOLOGI Local LLM semakin menarik bagi pengguna yang membutuhkan sistem AI fleksibel dan tidak selalu tergantung pada jaringan.
Privasi Data Menjadi Alasan Banyak Pengguna Memilih AI Lokal
Selain performa, privasi menjadi salah satu alasan penting mengapa Local LLM Runtime semakin banyak diperhatikan karena data dapat diproses secara langsung pada perangkat pengguna. Data berupa dokumen, catatan, dan berbagai informasi sensitif dapat tetap berada pada perangkat ketika seluruh pemrosesan dilakukan secara lokal. Pemrosesan di perangkat memungkinkan pengguna memiliki kontrol lebih jelas terhadap tempat data berada serta aplikasi yang diperbolehkan membacanya.
Namun penggunaan lokal tidak otomatis membuat seluruh sistem sepenuhnya aman karena keamanan tetap dipengaruhi oleh konfigurasi perangkat, aplikasi, jaringan, model, dan kebiasaan pengguna. Apabila perangkat memiliki malware atau kontrol akses yang buruk, data yang diproses secara lokal tetap berpotensi mengalami kebocoran. Karena itu perkembangan TEKNOLOGI AI lokal tetap perlu disertai kebiasaan keamanan seperti pembaruan sistem, enkripsi, perlindungan akun, dan pengelolaan izin aplikasi.
GPU NPU dan Memori Menjadi Penggerak Local LLM Runtime
Peningkatan kemampuan perangkat keras membuat AI lokal semakin mudah digunakan karena komputer terbaru memiliki sumber daya yang semakin kuat untuk pemrosesan kecerdasan buatan. GPU dapat mempercepat berbagai operasi model sementara NPU dirancang untuk menangani beban kerja kecerdasan buatan dengan efisiensi yang lebih baik pada perangkat tertentu. Ketersediaan memori sistem serta memori grafis sangat memengaruhi model apa yang dapat dijalankan dan seberapa panjang konteks yang bisa diproses.
Pengguna tidak selalu membutuhkan perangkat kelas tertinggi karena model yang lebih kecil dan teroptimasi dapat memberikan hasil yang memadai untuk berbagai pekerjaan ringan hingga menengah. Model sebaiknya dipilih berdasarkan spesifikasi komputer dan kebutuhan tugas agar pengguna tidak menjalankan ukuran yang terlalu berat bagi perangkat. Pendekatan tersebut membuat TEKNOLOGI Local LLM semakin inklusif karena pengguna dapat memilih model berdasarkan kemampuan perangkat tanpa harus selalu mengejar ukuran terbesar.
AI Lokal Menawarkan Banyak Fungsi untuk Pengguna dan Pengembang
AI lokal dapat digunakan untuk beragam pekerjaan mulai dari merangkum informasi, membantu penulisan, menganalisis dokumen, hingga mendampingi pengembangan perangkat lunak. Developer dapat memasukkan model lokal ke dalam aplikasi untuk menghadirkan fitur kecerdasan buatan yang bekerja langsung dari perangkat pengguna. Hal ini mendorong perkembangan aplikasi yang tidak terlalu bergantung pada layanan jarak jauh sekaligus menawarkan kontrol data yang lebih besar.
Pada lingkungan bisnis, AI lokal berpotensi dimanfaatkan untuk mencari informasi internal, membantu mengelola pengetahuan, dan menjalankan otomatisasi sesuai aturan perusahaan. Model dapat digabungkan dengan basis data maupun sistem pencarian lokal agar respons lebih relevan terhadap informasi yang tersedia di lingkungan tertentu. Pemanfaatan seperti ini memperlihatkan bagaimana TEKNOLOGI Local LLM dapat berkembang dari sekadar chatbot menjadi komponen produktivitas yang terintegrasi dengan berbagai sistem.
Masa Depan AI Menggabungkan Pemrosesan Lokal dan Cloud
Meningkatnya Local LLM Runtime tidak berarti layanan cloud akan sepenuhnya ditinggalkan karena kedua pendekatan memiliki keunggulan masing masing. Cloud tetap menarik untuk menjalankan model yang sangat besar atau tugas yang membutuhkan sumber daya komputasi tinggi sementara pemrosesan lokal lebih cocok untuk kebutuhan yang mengutamakan respons cepat, privasi, dan ketersediaan offline. Pengguna dapat memilih keduanya berdasarkan kompleksitas tugas, sensitivitas informasi, biaya, dan kemampuan hardware yang dimiliki.
Pendekatan hybrid bahkan berpotensi menjadi semakin umum ketika tugas sederhana dijalankan secara lokal sedangkan pekerjaan yang membutuhkan kemampuan lebih besar diteruskan ke layanan cloud. Pendekatan gabungan dapat menghadirkan kombinasi antara performa, kontrol data, kapasitas komputasi, serta kemudahan penggunaan. Arah tersebut menunjukkan bahwa masa depan TEKNOLOGI AI kemungkinan tidak hanya berpusat pada cloud tetapi juga pada distribusi pemrosesan yang semakin dekat dengan perangkat pengguna.
Kesimpulan Local LLM Runtime dan Masa Depan AI Lokal
Local LLM Runtime menunjukkan perubahan penting pada 2026 ketika AI semakin mudah diproses secara langsung melalui perangkat pengguna tanpa ketergantungan penuh terhadap layanan cloud. Keunggulan dalam hal kecepatan, privasi, akses offline, dan fleksibilitas menjadikan Local LLM semakin menarik untuk kebutuhan pribadi maupun profesional. Peningkatan kemampuan hardware dan efisiensi model membantu membawa Local LLM menuju lebih banyak jenis komputer serta skenario penggunaan. Dengan perkembangan yang terus berlanjut, TEKNOLOGI Local LLM berpotensi menjadi bagian penting dari ekosistem AI masa depan sekaligus memberi pengguna lebih banyak pilihan mengenai bagaimana dan di mana kecerdasan buatan dijalankan.