Amazon Rilis TorchNeuron agar Aplikasi PyTorch Bisa Berjalan di Chip Trainium
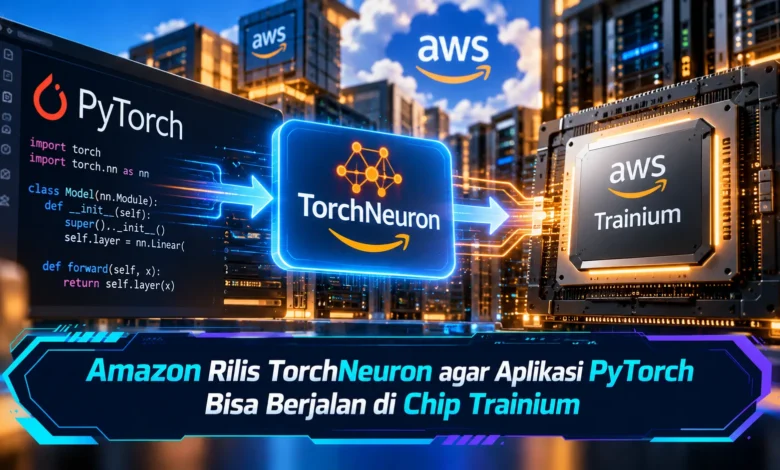
Amazon memperkenalkan TorchNeuron pada 19 Oktober 2026 sebagai langkah penting dalam memperluas penggunaan chip kecerdasan buatan AWS Trainium. Perangkat lunak ini memungkinkan pengembang menjalankan aplikasi dan model AI berbasis PyTorch pada chip Trainium tanpa harus menulis ulang sebagian besar kode yang sudah digunakan. TorchNeuron hadir dalam versi beta publik pada 20 Oktober 2026 dengan lisensi sumber terbuka Apache 2.0. Inovasi TEKNOLOGI ini menjadi perhatian karena berpotensi mengurangi ketergantungan pengembang terhadap satu platform perangkat keras. Selain membuka pilihan infrastruktur komputasi AI, Amazon juga ingin mempermudah perusahaan mengoptimalkan biaya dan meningkatkan fleksibilitas pengembangan kecerdasan buatan.
Mengenal TorchNeuron dan Inovasi Terbaru Amazon AWS
Perangkat lunak TorchNeuron hadir sebagai backend native untuk framework PyTorch yang dirancang untuk mempermudah penggunaan perangkat keras Amazon. Dengan memanfaatkan sistem ini, pengembang berpeluang memindahkan aplikasi pembelajaran mesin pada perangkat keras akselerator milik Amazon dengan kebutuhan modifikasi aplikasi yang lebih terbatas. Jika dibandingkan dengan pendekatan migrasi yang membutuhkan perubahan besar pada perangkat lunak, TorchNeuron menggunakan mekanisme ekstensi resmi PyTorch agar perangkat Trainium dikenali sebagai target komputasi. Pendekatan ini membuka pilihan pengembangan baru bagi peneliti AI.
Perusahaan AWS memperkenalkan TorchNeuron menjelang PyTorch Conference North America yang menjadi lokasi peluncuran sumber terbuka perangkat lunak tersebut. Backend PyTorch tersebut diperkenalkan melalui rilis beta untuk umum pada 20 Oktober 2026 dengan lisensi Apache 2.0. Penggunaan lisensi tersebut mendukung pemeriksaan serta pengembangan perangkat lunak sesuai persyaratan penggunaan perangkat lunak terbuka. Sistem integrasi ini dapat digunakan pada infrastruktur berbasis Trainium2 maupun Trainium3. Berkat kompatibilitas tersebut, Amazon membuka kesempatan bagi pengembang untuk mencoba alternatif akselerator tanpa mengganti seluruh lingkungan pengembangan.
Cara Kerja TorchNeuron dalam Menjalankan PyTorch di Trainium
Cara kerja TorchNeuron memanfaatkan sistem ekstensi resmi PyTorch yang tersedia melalui antarmuka PrivateUse1. Mekanisme ekstensi ini memberikan kemampuan untuk pengenalan jenis perangkat komputasi baru tanpa mengganti struktur dasar aplikasi. Berkat integrasi tersebut, chip Trainium dapat diakses menggunakan identitas perangkat neuron. Pengembang kemudian, memiliki kemampuan memilih Trainium sebagai target komputasi melalui konfigurasi pemuatan model. Rancangan perangkat lunak ini mengurangi kebutuhan mempelajari antarmuka khusus ketika melakukan inferensi model.
Untuk melengkapi kemampuan backend, TorchNeuron mendukung dua pendekatan eksekusi, yaitu eager execution dan torch.compile. Ketika menggunakan eager execution, operasi PyTorch dijalankan secara langsung sehingga pengembang lebih mudah melakukan debugging. Sementara itu, torch.compile membantu meningkatkan efisiensi eksekusi model. TorchNeuron juga memungkinkan penggunaan Neuron Kernel Interface atau NKI. Antarmuka pemrograman ini memberikan kendali lebih mendalam terhadap bagian aplikasi yang membutuhkan performa tinggi. Berkat fleksibilitas ini, pengguna berpeluang memilih pendekatan pemrosesan berdasarkan kebutuhan penelitian atau produksi.
Dukungan TorchNeuron untuk Model AI dan Ekosistem Hugging Face
Keunggulan teknis berikutnya dari TorchNeuron adalah integrasinya dengan ekosistem perangkat lunak AI. Ekosistem pengembangan Hugging Face memiliki peranan dalam perluasan kompatibilitas. Berkat pengembangan bersama ekosistem PyTorch, pustaka Transformers dan Diffusers memiliki jalur penggunaan menuju akselerator Amazon. Pustaka Transformers menjadi komponen penting dalam pengembangan model generatif, sedangkan Diffusers berkaitan dengan model difusi. Dalam kebutuhan komputasi berskala besar, TorchNeuron mendukung API pemrosesan terdistribusi seperti Fully Sharded Data Parallelism dan tensor parallelism. Dukungan ini berguna untuk membagi pekerjaan pelatihan pada beberapa akselerator sekaligus.
Meski cakupan dukungannya semakin luas, TorchNeuron masih memiliki keterbatasan pada operasi tertentu. Dalam dokumentasi teknis, sejumlah fitur PyTorch belum tersedia pada backend tersebut. Fitur yang masih memiliki batasan meliputi komputasi menggunakan representasi tensor jarang, NestedTensor, serta sejumlah bentuk dinamis dan simbolis. Selain itu, operasi yang belum didukung oleh jalur komputasi Trainium dapat membutuhkan penanganan alternatif. Untuk menghindari kesalahan implementasi, pengguna perlu menguji operasi yang digunakan sebelum mengadopsi Trainium dalam skala besar. Langkah ini memberikan gambaran kebutuhan optimasi secara lebih realistis.
Manfaat TorchNeuron bagi Pengembang dan Perusahaan AI
Nilai praktis yang ditawarkan sistem ini adalah fleksibilitas memilih infrastruktur AI. Dalam proses migrasi tradisional, aplikasi yang dioptimalkan pada perangkat keras khusus sering memerlukan modifikasi kode ketika menggunakan arsitektur komputasi baru. Dengan TorchNeuron, pengembang memiliki kesempatan menguji Trainium dengan perubahan terbatas. Kemampuan tersebut dapat mengurangi pekerjaan migrasi awal. Meski menawarkan kemudahan, penggunaan pada sistem produksi tetap membutuhkan pengujian performa. Melalui tahapan evaluasi yang benar, perusahaan berpeluang memilih solusi komputasi yang lebih sesuai.
Dari sisi biaya, AWS Trainium menjadi salah satu pilihan infrastruktur pelatihan dan inferensi. Integrasi perangkat lunak baru tersebut mendukung pengujian alternatif komputasi antara Trainium dan perangkat keras lainnya. Efisiensi biaya yang diharapkan perlu dihitung berdasarkan penggunaan nyata. Aspek perhitungan penting mencakup tarif sumber daya komputasi, kecepatan pelatihan model, pemanfaatan akselerator, serta pengeluaran operasional pendukung. Untuk perusahaan yang menjalankan model besar, harga komputasi yang lebih terjangkau belum tentu menjadi pilihan paling ekonomis apabila dibutuhkan optimasi tambahan yang mahal. Dengan pertimbangan tersebut, pengujian berdasarkan beban kerja sesungguhnya menjadi langkah yang penting.
Persiapan Menjalankan Model PyTorch dengan TorchNeuron
Bagi pengguna yang tertarik menggunakan backend baru ini sebaiknya memastikan akses ke infrastruktur Trainium dengan akselerator dari keluarga Trainium yang didukung. Selain perangkat keras, pengguna harus menyesuaikan versi pustaka pengembangan dengan rilis AWS Neuron yang sedang digunakan. Backend ini didistribusikan melalui paket torch-neuronx dari saluran distribusi perangkat lunak AWS. Proses instalasi perlu mengikuti petunjuk versi terbaru karena kombinasi paket menentukan keberhasilan instalasi. Setelah lingkungan siap, pengembang dapat mulai memindahkan model ke perangkat neuron dan memeriksa hasilnya secara bertahap.
Langkah evaluasi berikutnya sebaiknya berfokus pada ketepatan hasil sebelum meningkatkan ukuran pekerjaan. Pengembang dapat membandingkan keluaran model antara lingkungan komputasi sebelumnya dan Trainium. Untuk evaluasi yang lebih lengkap, TorchNeuron menyediakan integrasi profiler bersama Neuron Explorer. Berkat dukungan analisis performa, pengembang dapat menelusuri operasi yang membutuhkan waktu besar. Data pemantauan tersebut memberikan dasar pengambilan keputusan teknis. Pada pekerjaan yang lebih kompleks, pengujian memori, pengelolaan distribusi komputasi, dan evaluasi konsumsi sumber daya perlu mendapat perhatian khusus.
Dampak Inovasi Amazon TorchNeuron terhadap Pengembangan Kecerdasan Buatan
Diperkenalkannya backend TorchNeuron menunjukkan inovasi yang menarik dalam ekosistem perangkat keras kecerdasan buatan. Melalui dukungan backend native PyTorch untuk Trainium2 dan Trainium3, Amazon membantu pengembang mempertahankan alur kerja ketika menjalankan model pembelajaran mesin. Kemampuan menjalankan mode eager, torch.compile, serta dukungan terhadap ekosistem pengembangan populer memperluas peluang penerapan. Kendati memiliki potensi besar, perhitungan biaya nyata tetap menjadi pertimbangan penting bagi perusahaan. Seiring meningkatnya kebutuhan komputasi AI, TorchNeuron berpotensi memperluas pilihan pengembang. Dari sudut pandang Anda, apakah integrasi perangkat lunak AI lintas perangkat keras akan mengubah persaingan industri chip? Sampaikan pandangan Anda mengenai masa depan TorchNeuron.