AI Inference Engine Optimization 2026 Jadi Kunci Mempercepat Pemrosesan AI di Perangkat Modern
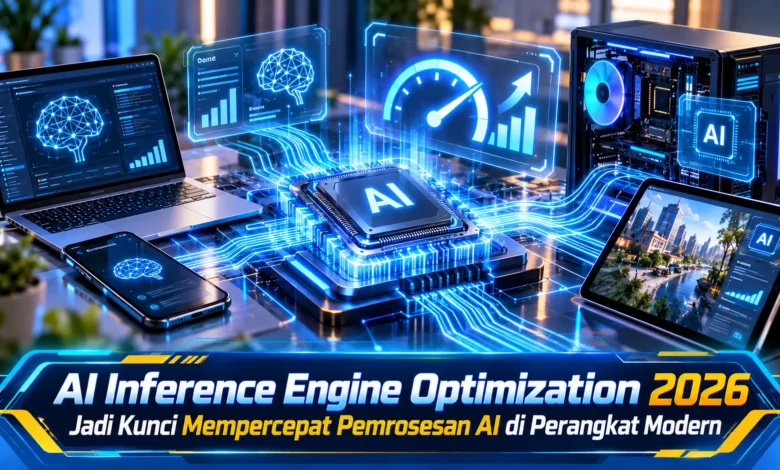
Perkembangan kecerdasan buatan pada 2026 tidak hanya berfokus pada pembuatan model yang semakin canggih, tetapi juga pada bagaimana model tersebut dapat dijalankan secara cepat dan efisien. AI Inference Engine Optimization menjadi bagian penting karena proses inference menentukan seberapa cepat perangkat menghasilkan respons setelah menerima input. Optimalisasi pada tahap ini semakin relevan ketika teknologi AI hadir di smartphone, laptop, kendaraan, perangkat wearable, kamera pintar, hingga berbagai perangkat edge yang membutuhkan respons cepat dengan konsumsi daya tetap terkendali.
Memahami Cara Kerja AI Inference Engine Optimization
AI Inference Engine Optimization pada dasarnya merupakan proses optimalisasi yang bertujuan mempercepat eksekusi model kecerdasan buatan pada perangkat. Ketika model telah melalui tahap training, proses inference dilakukan setiap kali sistem menerima masukan baru. Tahapan ini memiliki pengaruh besar terhadap seberapa responsif teknologi berbasis AI ketika digunakan secara langsung.
Optimalisasi inference bukan sekadar usaha untuk membuat pemrosesan berlangsung lebih cepat. Tim pengembang perlu memperhitungkan kebutuhan memori, penggunaan daya, tingkat latensi, kemampuan perangkat, dan jenis hardware yang digunakan. Kombinasi faktor tersebut perlu diperhatikan karena kecepatan tinggi belum tentu efisien apabila penggunaan daya dan memorinya berlebihan.
Kebutuhan Inference Cepat Meningkat di Perangkat Modern
Meningkatnya penggunaan AI secara lokal menjadikan kecepatan inference sebagai salah satu faktor penting dalam teknologi modern. Fitur seperti pemrosesan gambar, penerjemahan, pengenalan suara, penyuntingan konten, asisten AI, dan analisis sensor membutuhkan respons yang cepat. Jika proses inference terlalu lambat, pengguna dapat merasakan jeda yang mengurangi kenyamanan ketika berinteraksi dengan perangkat.
Kecepatan juga menjadi penting untuk aplikasi yang membutuhkan keputusan hampir secara real time. Perangkat modern dapat memperoleh informasi dari kamera, mikrofon, sensor pergerakan, maupun komponen lainnya secara berkelanjutan. Optimalisasi inference engine memungkinkan data diproses dengan latensi lebih rendah sehingga teknologi dapat menghasilkan tindakan atau informasi dengan lebih cepat.
Quantization Menjadi Teknik Penting untuk Mempercepat AI
Quantization menjadi salah satu teknik yang dapat membantu meningkatkan efisiensi pemrosesan AI. Metode ini memanfaatkan format numerik dengan tingkat presisi yang lebih rendah untuk mengurangi kebutuhan penyimpanan serta operasi komputasi. Dalam implementasi yang sesuai, model dapat menjadi lebih ringan dan lebih cepat dijalankan tanpa harus mengubah fungsi utamanya.
Meski menawarkan keuntungan, penurunan presisi tetap harus diuji sebab optimalisasi berlebihan berpotensi memengaruhi akurasi maupun kualitas keluaran. Tim pengembang harus mencari keseimbangan antara kapasitas model, performa inference, konsumsi daya, serta mutu keluaran. Dengan demikian, model sebaiknya diuji pada perangkat yang sebenarnya agar konfigurasi teknologi dapat disesuaikan dengan kebutuhan nyata.
Perangkat Modern Mengandalkan Akselerasi Khusus untuk AI
Optimalisasi perangkat lunak dapat memberikan hasil lebih baik ketika disesuaikan dengan kemampuan hardware yang tersedia. Hardware modern dapat menggabungkan CPU, GPU, NPU, maupun komponen akselerasi khusus yang masing masing mempunyai karakteristik dalam menjalankan model AI. Mesin inference perlu mengatur pembagian operasi sehingga komponen hardware dapat digunakan secara efektif.
Neural Processing Unit semakin penting karena hardware tersebut dikembangkan untuk mempercepat berbagai operasi kecerdasan buatan secara efisien. Walaupun hardware memiliki kemampuan tinggi, hasil akhirnya tetap ditentukan oleh model, inference engine, compiler, driver, memori, dan optimalisasi sistem secara keseluruhan. Hal tersebut membuat optimalisasi teknologi AI perlu dilakukan melalui integrasi software dan hardware, bukan hanya menggunakan satu komponen yang kuat.
Efisiensi Daya Menjadi Tantangan Pemrosesan AI Lokal
Pemrosesan AI secara lokal menawarkan manfaat seperti respons yang cepat dan kebutuhan koneksi cloud yang lebih rendah untuk beberapa fungsi. Namun, smartphone, laptop, wearable, dan perangkat edge memiliki batas konsumsi energi serta kapasitas pendinginan. Proses inference yang membutuhkan sumber daya besar dapat menguras baterai dan meningkatkan temperatur perangkat sehingga kenyamanan berkurang.
AI Inference Engine Optimization berusaha mengurangi operasi yang tidak diperlukan sekaligus memanfaatkan hardware dengan cara yang lebih efisien. Teknik seperti pengelolaan memori yang lebih baik, optimasi graph, penggabungan operasi, quantization, serta penjadwalan komputasi dapat membantu meningkatkan efisiensi. Sasaran akhirnya adalah membuat teknologi AI tetap responsif tanpa memberikan beban berlebihan terhadap daya, memori, maupun kemampuan komputasi perangkat.
Software dan Model Menentukan Efisiensi Pemrosesan AI
Kecepatan AI tidak hanya ditentukan oleh seberapa kuat prosesor yang digunakan. Desain model, tipe operasi, skala parameter, representasi data, sistem memori, compiler, dan runtime dapat memengaruhi kecepatan inference. Oleh sebab itu, peningkatan performa yang efektif perlu melihat seluruh proses mulai dari model sampai perangkat keras.
Tim pengembang dapat mengoptimalkan model dengan mempertimbangkan kemampuan perangkat tujuan. Sistem yang berjalan pada server bertenaga besar mungkin memerlukan strategi berbeda dibandingkan model untuk ponsel atau perangkat wearable. Pendekatan yang disesuaikan dengan perangkat membantu memperoleh keseimbangan antara kualitas, kecepatan, konsumsi energi, dan penggunaan memori.
Kesimpulan
AI Inference Engine Optimization pada 2026 memiliki peran penting karena kecanggihan model perlu diimbangi dengan pemrosesan yang responsif dan hemat sumber daya. Pendekatan melalui quantization, manajemen memori, graph optimization, operator fusion, compiler, runtime, serta pemanfaatan hardware khusus dapat meningkatkan efisiensi pemrosesan. Kebutuhan tersebut semakin penting ketika teknologi AI mulai banyak dijalankan secara langsung pada smartphone, laptop, wearable, kendaraan, dan berbagai perangkat edge. Melalui integrasi model, software, serta hardware yang tepat, perangkat dapat menjalankan AI secara lebih responsif tanpa mengabaikan penggunaan energi. Pembaca juga dapat memantau perkembangan teknologi inference engine untuk memahami bagaimana optimalisasi tersebut membentuk generasi perangkat AI berikutnya.